Скачать страницу из Wayback Machine
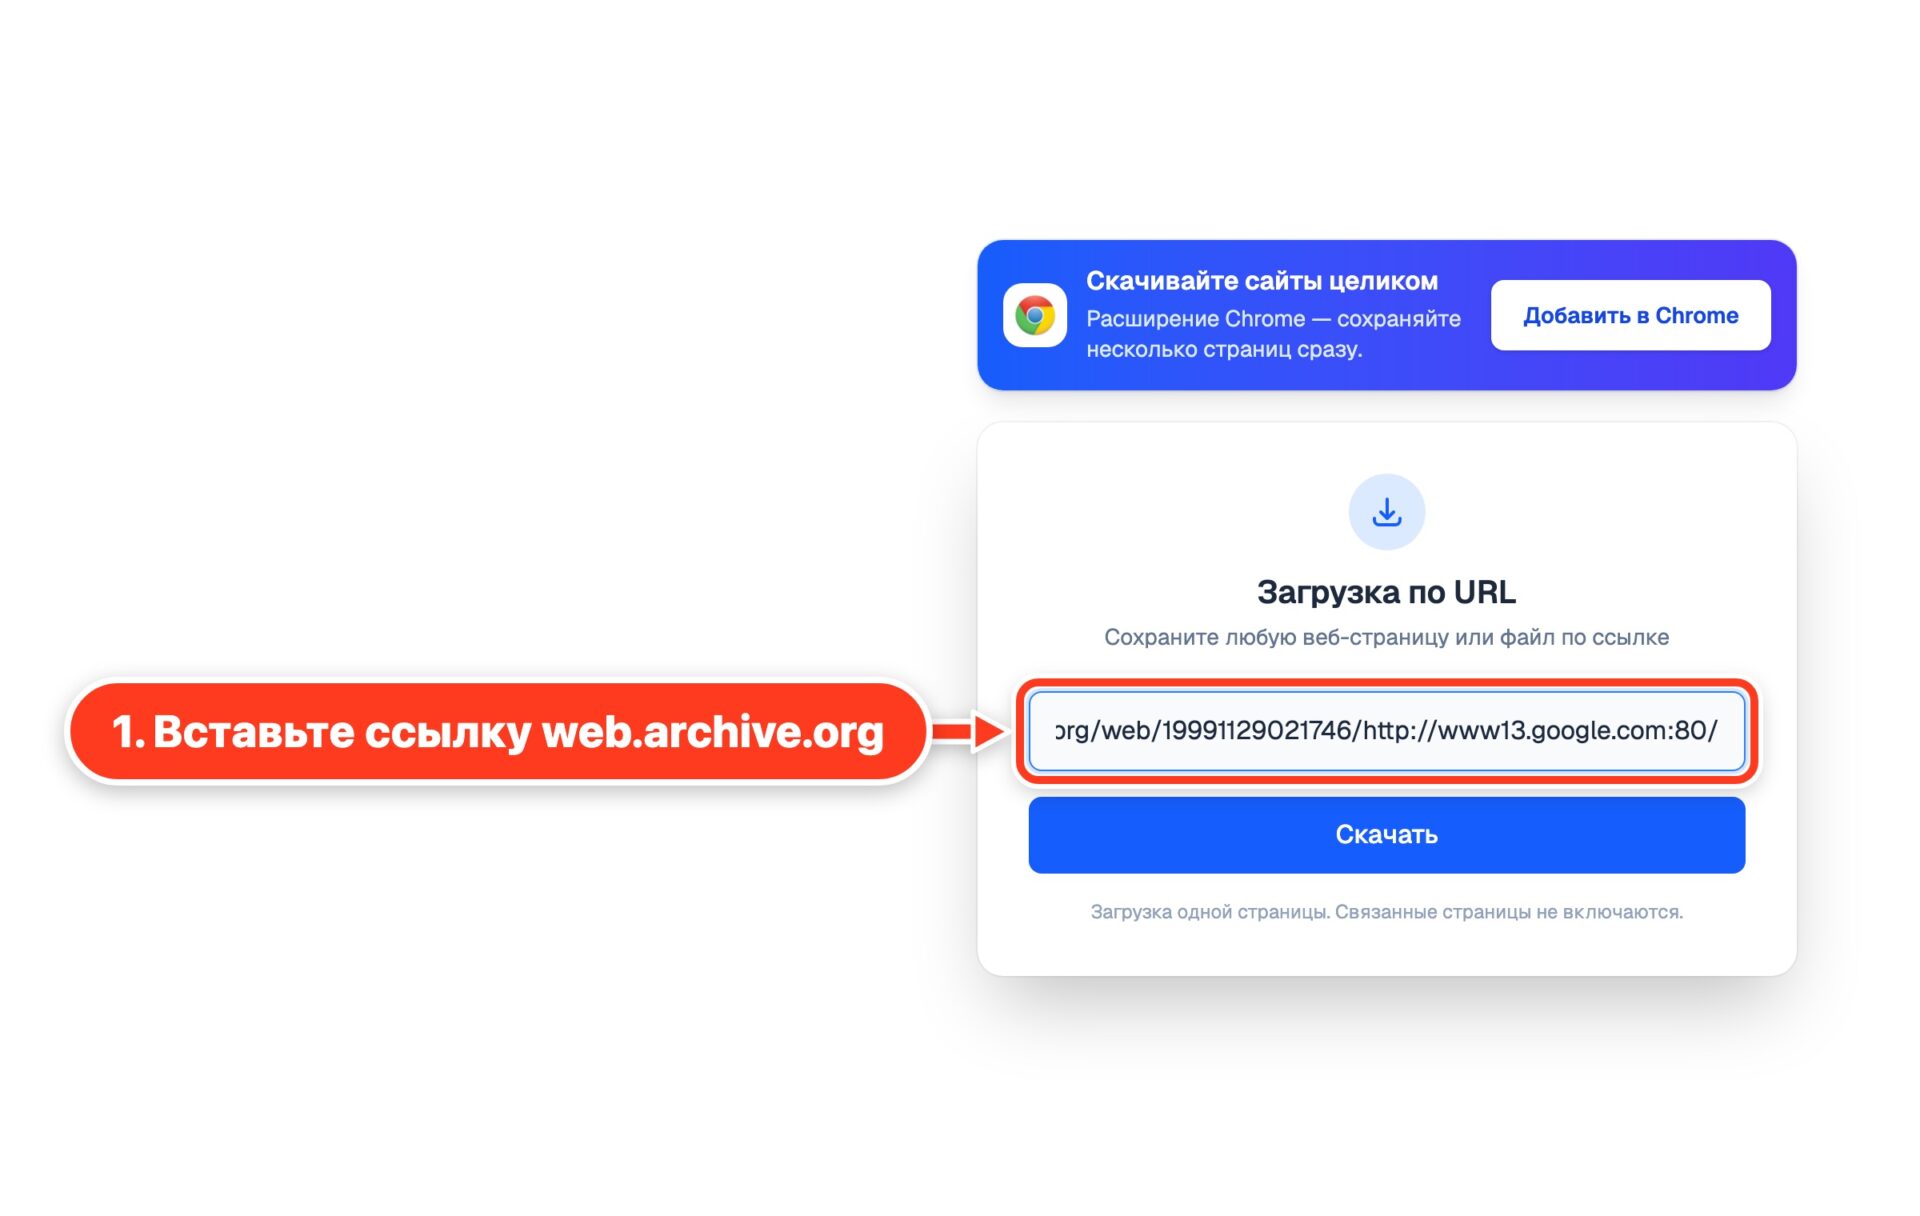
Вставьте ссылку на страницу в Wayback Machine и скачайте её такой, какой её сохранил архив: исходный HTML с картинками, стилями и скриптами из той же копии, в одном файле, который открывается без интернета. Без панели архива и без установки программ.
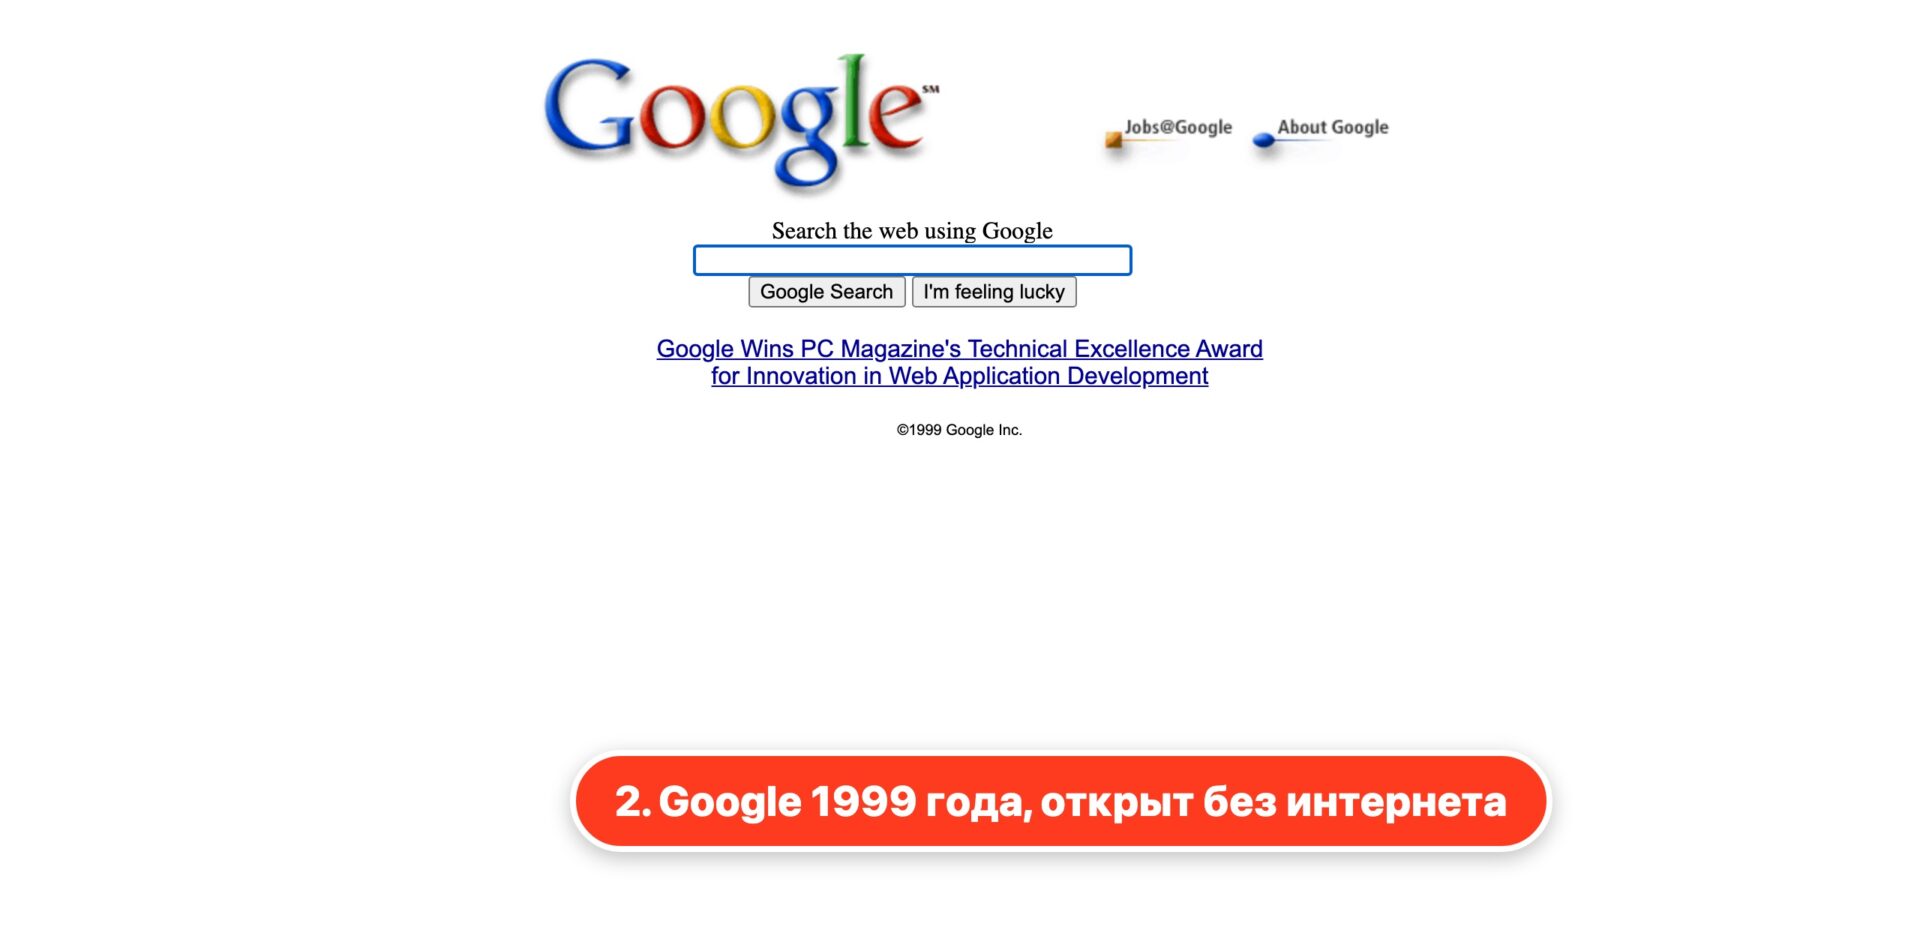
Сохранённый файл открывается в любом браузере, даже без интернета:
Какие ссылки подходят?
Любая ссылка на сохранённую копию на web.archive.org:
web.archive.org/web/20150315000000/https://example.com/— одна точная копияweb.archive.org/web/2015/https://example.com/— копия, ближайшая к этой дате- ссылка из адресной строки, пока вы листаете архив
Ссылки поиска и календаря со звёздочкой * не ведут на одну копию. Откройте календарь, выберите дату и скопируйте ссылку открывшейся страницы.
Что я получу?
Одну страницу в том виде, в каком её сохранил Wayback Machine:
- исходный HTML без панели архива и переписанных скриптов
- картинки и стили из той же копии, сохранённые в файл
- ссылки, которые ведут на ту же копию в архиве, а не на сегодняшний сайт
Можно скачать весь сайт из архива?
Здесь нет: инструмент сохраняет по одной странице. Чтобы получить все сохранённые страницы сайта, нужна программа для командной строки, которая пройдёт по всем его копиям.
Почему иногда долго?
Internet Archive в часы нагрузки отвечает медленно и ограничивает скорость скачивания для всех. Страница с большим количеством картинок может скачиваться минуту. Если видите, что Wayback Machine занят, подождите несколько минут и попробуйте снова.
Это бесплатно?
Да. Без регистрации, без ограничений и без рекламы. Мы не храним скачанные страницы.
Другие инструменты
Чтобы сохранить страницу из живого интернета, используйте URL Download. Все картинки страницы скачает загрузчик изображений с сайта.
Это разрешено?
Internet Archive открывает свои коллекции для исследований и учёбы. Сохранённые страницы по-прежнему принадлежат авторам, поэтому используйте скачанное для исследований, справки или восстановления своего сайта и не публикуйте чужие работы заново.